
【博客教程】博客园的随笔批量导出并转换为Markdown文件
博客园的随笔批量导出并转换为Markdown文件
将博客园的全部随笔 连同图片、分类 一键导出为 Hexo 可用的 Markdown 文件。
阿里云盘工具地址
支持两种备份格式(自动识别,无需设置):
.xml(XML/RSS):文章正文/日期/图片齐全(推荐).db/.sqlite(SQLite 新版备份):不含分类(博客园格式限制),图片归入「未分类」目录
核心功能:
- ⏰ 增量导出:运行时可指定日期,只解析该日期之后发布的新文章;不指定则全量转换
- 🧹 标题自动规范:第一步先统一去掉标题开头的【分类】前缀,第二步根据博客园后台真实分类重新加回,保证前缀 100% 与后台分类一致
- 🖼️ 图片本地化:下载全部图片,按分类归档,正文引用自动改写为本地路径
- 📋 运行日志:每次运行自动生成
convert_log.txt,记录全部转换过程
⚠️ 博客园备份文件(无论 .xml 还是 .db)都不含分类字段(服务端格式限制)。分类通过第二步调用博客园官方 API 获取。
工具组成
1 | 工具目录/ |
使用步骤(两步)
第一步:解析备份文件,生成 Markdown + 下载图片
1. 导出备份文件
博客园后台 → 管理 → 备份/导出 → 创建备份 → 下载备份文件(.xml),放到工具目录。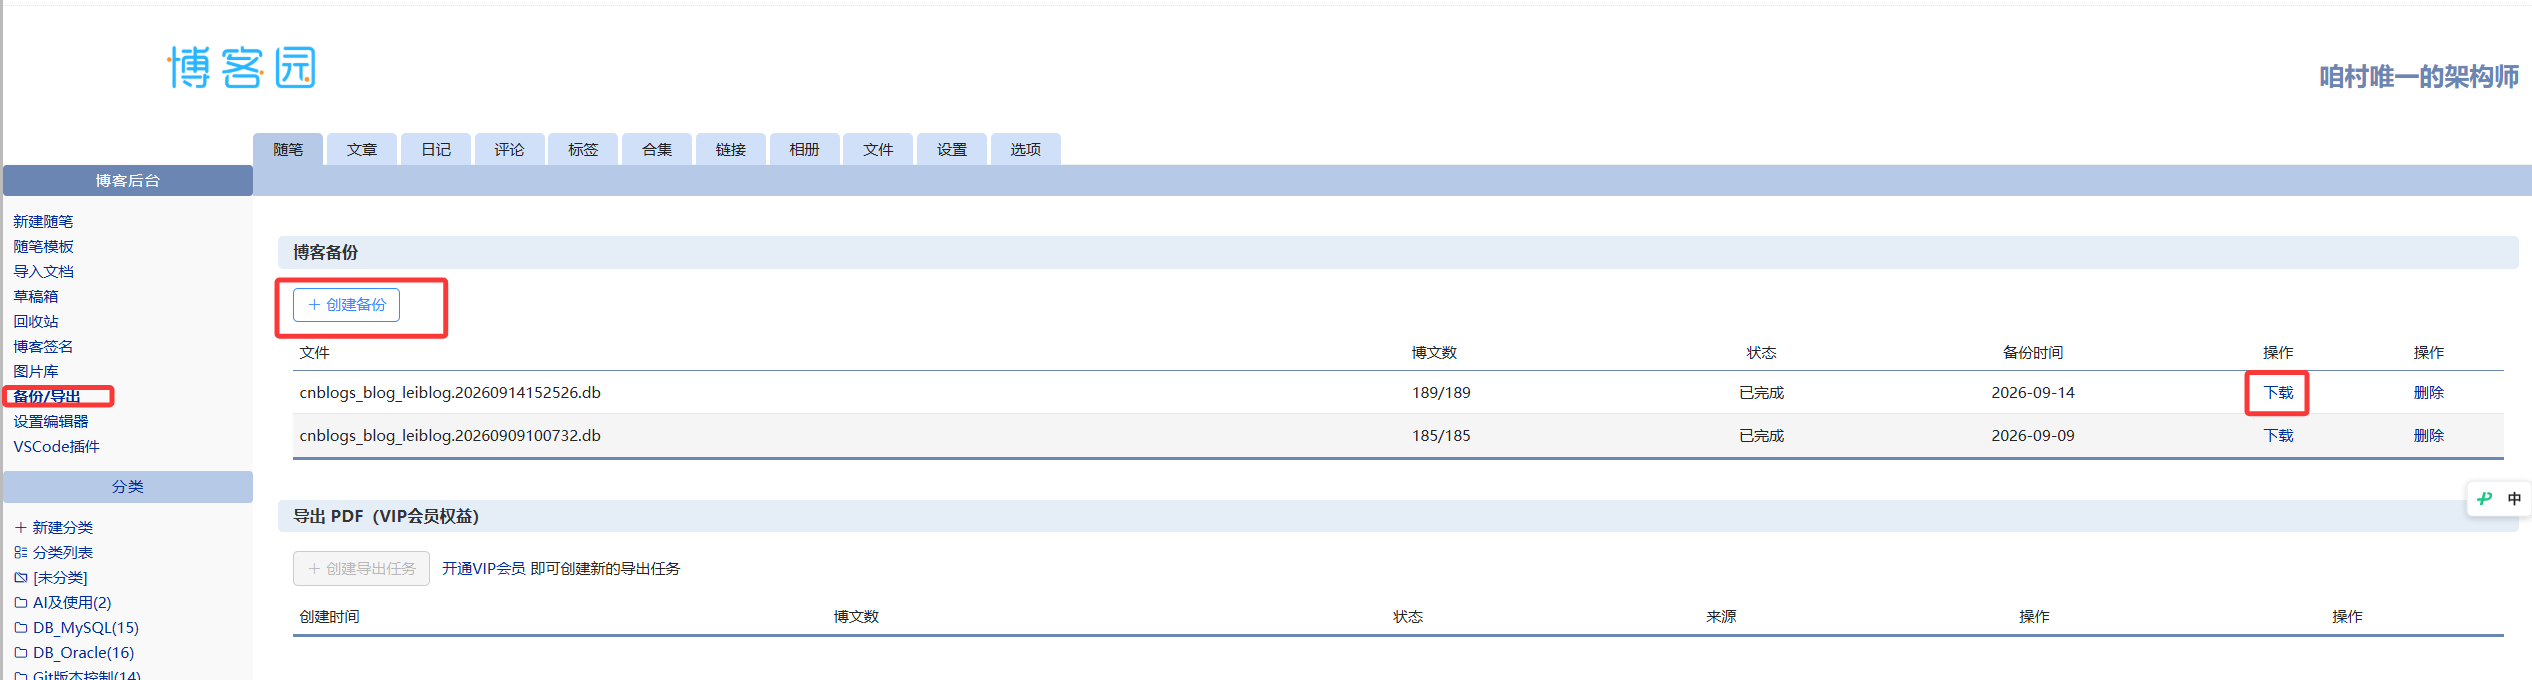
2. 运行
1 | # Windows:双击 run_windows.bat,或命令行: |
⚠️ 重要提示:python运行脚本的方式也可以不指定备份的文件名,会默认在脚本所在目录自动找备份文件。
3. 第一步做了什么
- 解析备份文件,为每篇文章生成 .md 文件
- 用正则
^【.*?】去掉标题开头的【分类】前缀(无论标题有没有前缀,最终 title 和文件名都不带前缀) - 去掉结尾的用户名后缀:自动从 XML 每篇文章自己的
<dc:creator>/<author>读取作者名动态清理(-作者名),兼容 RSS 直接文本(<author>leibytes</author>)和 Atom 嵌套(<author><name>leibytes</name></author>)两种结构,无需手动配置;BLOG_USERNAME_SUFFIX仍可额外配置一个固定后缀 - 下载所有图片到本地,暂时归入
images/未分类/ - front-matter 写入
link字段(博客园原文链接,第二步靠它提取文章 ID)
第一步输出:
1 | hexo_output/ |
第二步:获取分类信息,按分类归档
1. 创建令牌
打开 https://account.cnblogs.com/settings/tokens → 创建个人访问令牌(PAT)→ 复制令牌值。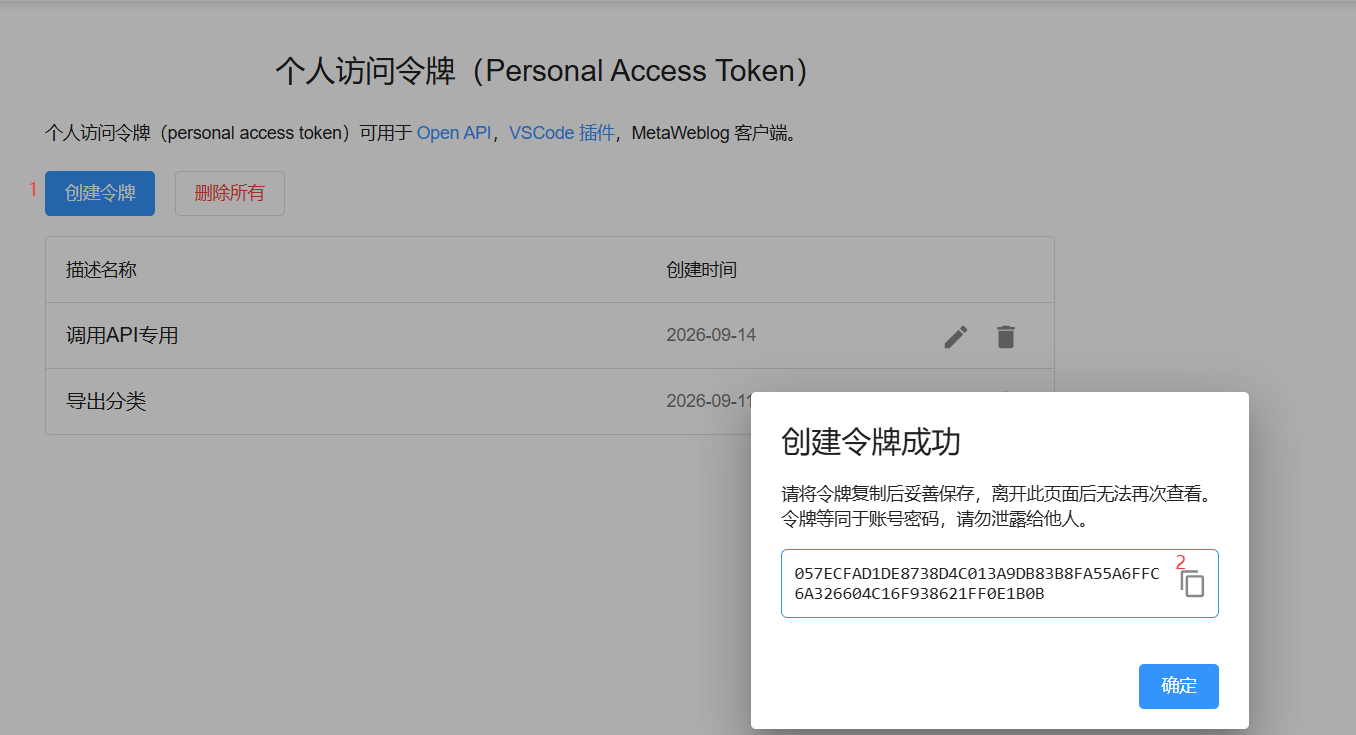
2. 运行
1 | python cnblogs_fetch_categories.py --pat "你的令牌" --output hexo_output |
⚠️ 重要提示:–output参数用于指定第二步要处理的Markdown目录,第一步的输出目录脚本里写死了
default="hexo_output",因此可不指定–output参数,除非第一步的输出目录有调整。
3. 第二步做了什么
- 用 PAT 调用博客园官方 API:拉分类映射 → 以 hexo_output 里的 md 为驱动,只抓取需要回填的文章(从 link 提取 ID,增量导出时只抓新增的几篇,不浪费在全量文章上)
- 通过文章 ID 精准匹配(从第一步写入的
link字段提取 ID,不依赖标题文本比对;无 link 时才用标题匹配兜底,标题匹配不写死任何用户名) - 拿到真实分类后:
- 给 front-matter 的
title加上【分类】前缀(取第一个分类) - 给 .md 文件名加上【分类】前缀
- 回填
categories:字段(支持多分类) - 把图片从
images/未分类/移动到images/对应分类/ - 批量修改正文图片引用路径
- 给 front-matter 的
最终输出:
1 | hexo_output/ |
💡 第二步跑完建议去令牌页面删除该令牌(脚本只读,不改动博客内容)。
命名规则(最终版)
| 项目 | 规则 | 示例 |
|---|---|---|
| 文章文件名 | 【分类】前缀 + 标题(分类来自 API) | 【DB_MySQL】navicat15的安装与激活.md |
| front-matter title | 与文件名一致 | title: '【DB_MySQL】navicat15的安装与激活' |
| front-matter categories | API 返回的真实分类 | categories:\n - DB_MySQL |
| 图片文件名 | 去【分类】前缀的标题截断30字符 + 序号 | navicat15的安装与激活_001.png |
| 图片目录 | 按分类分子目录 | images/DB_MySQL/ |
| 正文图片引用 | /images/分类名/图片名 |
 |
导入 Hexo
- 将
hexo_output/下的 .md 文件复制到 Hexo 项目的source/_posts/ - 将
hexo_output/下的images/整个文件夹复制到 Hexo 项目的source/下(最终为source/images/) - 本地预览:
1
hexo clean && hexo g && hexo s
- 说明:
- 不需要
post_asset_folder: true,不需要hexo-asset-image插件 - 部署到主站(
username.github.io):直接生效 - 部署到子路径(
username.github.io/仓库名/):需把脚本中IMAGE_URL_PREFIX = "/images"改为"/仓库名/images",重新运行导出
- 不需要
常见问题
| 问题 | 解决 |
|---|---|
| 找不到备份文件 | 确认 .xml / .db 文件和脚本在同一文件夹;脚本会自动查找 |
| 只有 .db 没有分类 | 博客园备份格式本身不含分类;用第二步 + PAT 一键补全 |
| 个别图片下载失败(403/超时/404) | 脚本已带防盗链请求头并校验真实图片格式;失败图片在 convert_log.txt 中标出,可手动下载后放入 images/<分类>/ 对应目录,并把正文中的远程链接改为 /images/<分类>/文件名 |
| 某篇文章没匹配到分类 | 检查该文章在博客园后台是否真的设置了分类;未匹配的文章保留无前缀标题,图片留在「未分类」目录 |
| 归集模式下图片 404 | 确认 images 文件夹复制到了 source/ 下;子路径部署需改 IMAGE_URL_PREFIX |
| Windows 标题含特殊字符 | 脚本已自动替换 \ / : * ? " < > |,如 PL/SQL → PL_SQL |
| 草稿文章 | .db 输入时私有/草稿文章输出到 hexo_output/_drafts/(Hexo 草稿目录,不发布) |
说明
- 第一步脚本只读取本地备份文件,不修改博客园账号任何内容
- 第二步脚本只用 PAT 读取文章列表和分类(只读操作),不改动博客内容
- 图片请求带
Referer: https://www.cnblogs.com/请求头,用于正常绕过防盗链 - 单张图片下载失败 3 次后跳过并记录,不影响其他文章
- 结果验证:文章全量转换 + 分类回填 + 图片归档全部通过
本博客所有文章除特别声明外,均采用 CC BY-NC-SA 4.0 许可协议。转载请注明来源 咱村唯一架构师!